 Techroomage
撐得久比答得快要緊:Grok 4.7 把模型競賽搬到數小時級任務
SpaceXAI 發布 Grok 4.7,訓練重心放在需要數小時完成的編碼與知識任務,每百萬詞元輸入 2 美元起,本文分析長任務競爭軸線、官方數據的讀法與後續可盯訊號。
SpaceXAI 發布 Grok 4.7,宣稱速度是同類模型的兩倍、價格只有一半,每百萬詞元輸入 2 美元起;更關鍵的訊號,是訓練重心移向需要數小時才能完成的任務。
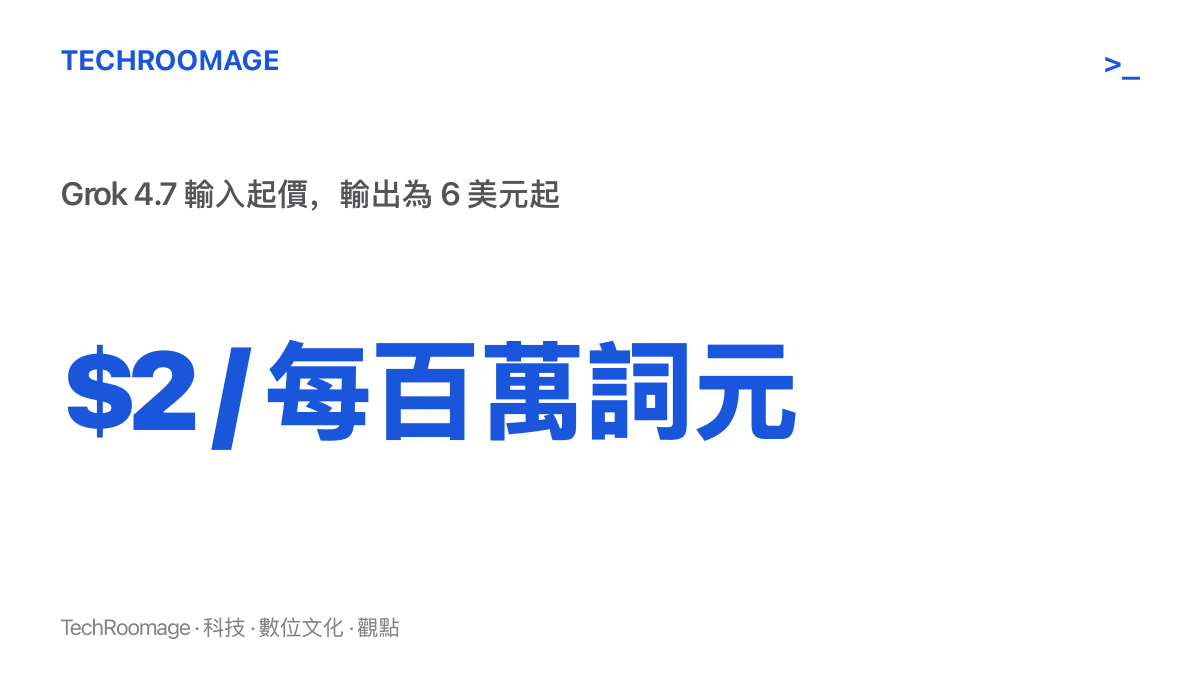
一個模型值多少錢,過去取決於它回答單一問題的品質;現在越來越取決於它能不能連續工作幾個小時不出錯。SpaceXAI 於 9 月 22 日發布的 Grok 4.7,把這條分界畫得相當明白。官方定位是該公司目前最強的編碼與知識處理模型,速度是同類模型的兩倍,價格只有一半,每百萬詞元輸入 2 美元起、輸出 6 美元起(IT之家註記約合人民幣 13.4 元與 40.2 元)。模型已透過 Cursor 與 Grok Build 提供,Grok API 同步開放,並支援第三方編碼工具、模型路由服務與雲端平臺。
價格與速度之外,發布說明裡資訊量最大的一句話其實是:訓練資料更加側重需要數小時才能完成的複雜任務。這句話決定了 Grok 4.7 在整場模型競賽裡站的位置,也決定了使用者該怎麼讀這次發布。
一個為「跑很久」而訓練的模型
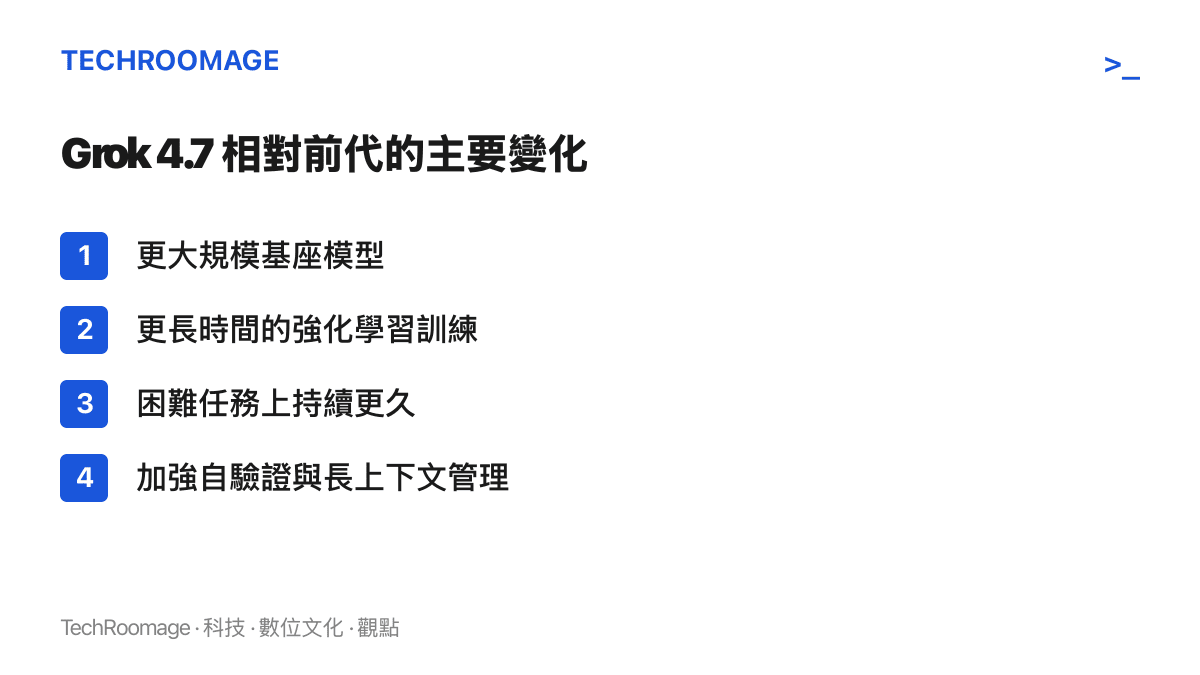
與前代 Grok 4.6 相比,Grok 4.7 採用規模更大的基座模型,並接受更長時間的強化學習訓練。官方描述了兩個行為上的差異:新模型能在困難任務上持續更長時間,並加強對自身輸出結果的檢查能力。配套的優化指向同一個方向,自驗證與長上下文管理被列為訓練重點。
這個設計取向對應的市場,是已經成形一段時間的代理式編碼工作流:開發者把整個功能需求交給 AI,讓它在程式碼庫裡讀檔、改碼、跑測試、自己回頭修錯,整個過程動輒數十分鐘到數小時。在這種場景裡,一次回答得很漂亮的價值有限,中途不迷失、能自我檢查才是決定可用與否的條件。
SpaceXAI 同時針對自家的 Grok Bot harness(模型外層的工具框架)做了原生訓練與最佳化,官方稱這提升了對話與一般知識工作的表現,文件與簡報生成能力也有改進。換句話說,這次交付的內容,是模型連同它外層那套框架一起調校過的組合。這正是目前開發者選型時最糾結的變數之一,我們先前分析過開發者在harness 與模型直連之間量依賴面積的兩難:框架功能多卻常在更新後出問題,直連穩定但擴充有限。Grok 4.7 選擇把兩者綁在一起出貨,等於把這份風險與好處一併交到使用者手上。
專業工作的帳,用基準測試先記一筆
在 GDPval 與 AA Briefcase 兩項基準測試中,Grok 4.7 均較 Grok 4.6 有所提升。這兩項測試的共同點值得留意:題目取自律師、護理師、金融分析師等專業人士的日常工作任務。官方對成績的表述是,已達到與其他前沿模型相近的水準。
這個措辭本身就有資訊量。在編碼戰場上,SpaceXAI 給出的是「速度兩倍、價格一半」的攻擊性對比;在專業知識工作上,給出的是「相近」這種追平式說法。兩種口徑並列,大致描出了官方自己評估的強弱分布:編碼是主戰場,知識工作是追趕中的第二戰線。
讀官方跑分的基本原則,是連同比法一起讀。這與我們在AMD 官方跑分要連同比法一起看一文中整理的判讀方式相同:對照組是誰、量測口徑為何、由誰出題,決定了倍數的實際分量。以 Grok 4.7 來說,「同類模型」的範圍未在發布說明中列明,CursorBench 4.0 上「價格與性能居同類前列」也屬於區間式表述,真正的排名要等第三方重測才能落定。
安全帳本:62.4% 與 3.3%
安全防護是這次發布著墨明顯較多的一塊。SpaceXAI 稱 Grok 4.7 採用全新安全防護體系,在拒答與抵抗越獄攻擊方面達到公司目前測試中的最高水準。
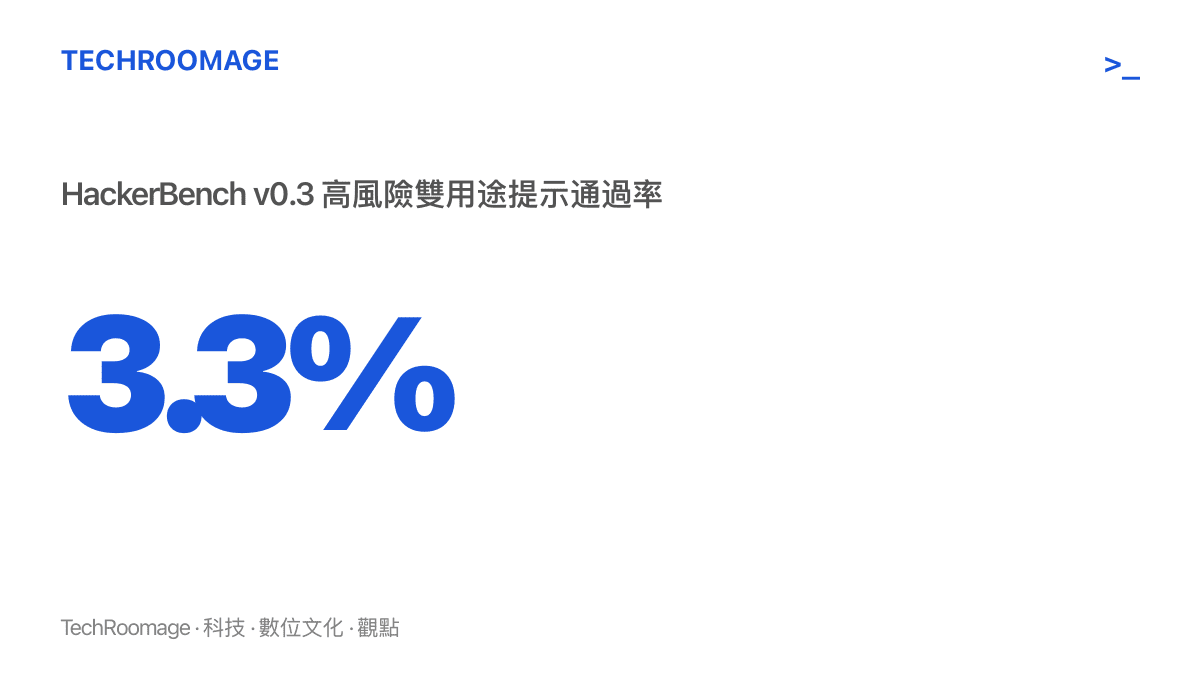
兩個具體數字可以對照著看。LatchBio 生物安全基準測試取得 62.4%;HackerBench v0.3 中,僅 3.3% 的高風險雙用途提示通過,官方同時強調較少阻擋合法的安全研究工作。後面這半句是雙用途防護的老難題:防護拉得太緊,滲透測試與防禦研究這類正當工作會先被擋在門外。SpaceXAI 的解法是分級處理,一般版本收緊高風險提示,另以邀請制向部分網路安全合作夥伴開放紅隊與防禦研究用途。對使用者的意義相當具體:若工作涉及資安測試,能不能用上這個模型,取決於拿不拿得到邀請,而非付不付得起帳單。
2 美元這個數字,寫給誰看
價格是把整場競賽往前推的力氣最大的變數之一。Grok 4.7 每百萬詞元輸入 2 美元起、輸出 6 美元起,運行速度與定價均與 Grok 4.6 相同,另提供輸出速度翻倍、價格也翻倍的高速版本。
「起價」與「高速版加倍」的設計,顯示價格已經是產品設計的一部分,而非單一數字。願意多付一倍換輸出速度的,多半是讓代理連跑數小時的團隊:在長任務場景,延遲會沿著整條工作流被放大。對一般使用者,2 美元這個錨點的意義是持續下壓的行情。前沿模型的每詞元價格一路走低,內建在編碼工具裡的 AI 功能,成本壓力只會越來越小,最終會反映在訂閱方案與功能下放的節奏上。
競爭對手接下來的動作也不難預期。當「速度兩倍、價格一半」的說法進入市場,同一張 CursorBench 榜單上的競爭者遲早要在價格或長任務穩定性上回應,否則就是在同一份報價單上被直接比下去。
接下來可盯的訊號
短期內值得留意幾件事。首先是第三方在 CursorBench 4.0 上的重測結果,特別是長時間執行任務的穩定性,這是官方說法唯一靠得住的驗收方式。其次是模型離開 Grok 自家框架、進到 Cursor 與其他第三方工具後的表現落差:原生訓練的綁定出貨是把雙面刃,綁得越深,跨工具的折損就成為新的檢驗項目。再來是邀請制網路安全存取的開放範圍與審核方式,這會決定「安全」在這個模型上是產品特色還是行銷敘事。最後是同業的價格回應,那是行情繼續下探或暫時止穩的直接指標。
回到使用者的判斷:把「兩倍速度、一半價格」當宣示方向讀,別當保證讀。真正確定的是競賽軸線的位置變了,模型比拚的項目從單次應答的聰明,移到數小時工作的可靠。對已經讓 AI 跑長任務的團隊,這是實際的選項擴增;對還在觀望的人,等一輪獨立測試再決定,成本不會高多少。