 Techroomage
一條走廊走了八十年:馮紐曼架構的老瓶頸,被 AI 運算重新推上檯面
從掛在知乎十年的架構之問讀起,說明馮紐曼儲存程式設計的原理、記憶體牆為何在 AI 時代發燙,以及四條想繞開它的新路線與後續可觀察的訊號。
程式與資料共用一條通道的設計,撐起了八十年來幾乎所有電腦;當搬資料的成本超過算資料,取代它的路線也從教科書走進了產品線。
2015 年前後,有人在知乎上丟出一個問題:「馮紐曼體系有一天會被打破嗎?會不會出現一種更高效的體系,致使整個計算機格局突變。」問題掛了十年,多數答案停留在原理層次的推想。這兩年它被重新翻出來討論,原因變得非常具體:AI 運算把這套八十年前的設計,撞上了一堵有名有姓的牆。
被問的到底是什麼
先給一句話版本。馮紐曼架構把程式和資料放進同一個記憶體,處理器透過同一條通道反覆讀取、執行、寫回。1945 年,數學家馮紐曼為美國的 EDVAC 計畫寫下報告草案,確立了「儲存程式」概念:指令也是資料,換程式不必換線路。1948 年,曼徹斯特大學的 Baby 機第一次讓這個想法真正跑起來,此後從主機房到智慧手錶,幾乎所有會算數的機器都是它的後代。
用一個比喻來看:一位廚師(處理器)配一座倉庫(記憶體),兩者之間只有一條走廊(匯流排)。廚師做菜得不斷回倉庫拿食譜與食材,做完再端回去。這種安排的好處是萬用,同一間廚房今天算報表、明天修照片;代價是廚師有大半時間花在走廊上。
那條走廊後來有了正式名字。1977 年,圖靈獎得主 John Backus 在得獎演說裡提出「馮紐曼瓶頸」,批評當時的程式語言被迫一句一句把資料餵進處理器,再快的硬體也只能排隊過走廊。
牆是何時撞上的
「記憶體牆」的說法,比生成式 AI 早了近三十年。1995 年,維吉尼亞大學的 Wulf 與 McKee 發表論文指出,處理器效能的成長長期快於 DRAM,兩者的速度差距終會大到處理器大部分時間在等資料。三十年後,大型模型訓練把這個教科書預言變成採購部門的日常。
這筆帳可以算得很直白。史丹佛大學的 Mark Horowitz 在 2014 年 ISSCC 會議上給出著名估算:從 DRAM 搬一個數字到處理器的耗能,大約是做一次加法的數百倍以上。GPU 裡的乘法器再密集,只要權重堆在幾公分外的記憶體裡,時間與電力就多半花在搬運上,運算單元反而經常待命。這正是 HBM 高頻寬記憶體這兩年被視為戰略物資的原因:把記憶體堆疊起來、直接搬到運算單元隔壁,用實體距離換頻寬。
同樣的壓力也往消費端滲。過去使用者煩惱的是儲存容量,現在連記憶體容量與頻寬都開始喫緊,微軟與華為同週都在擠記憶體的消息,就是端側裝置資源見底的訊號之一。
挑戰者一直都在,贏的很少
馮紐曼路線並非沒有對手。數位電腦普及之前,類比計算機用電壓的連續變化解微分方程,二戰期間算過彈道,最後敗在精度與泛用性。1970 與 80 年代,MIT 與曼徹斯特大學都打造過資料流機器,讓指令在資料到齊時自行觸發,不必排隊等程式計數器。日本 1982 年啟動的第五代電腦計畫押注邏輯式程式設計,十年後收場。另外,指令與資料分開存放的哈佛架構,至今活在微控制器與數位訊號處理器裡,這說明局部修正早就存在,只是從未動搖大局。
這套體系能贏八十年,靠的是兩件事。硬體端,它只需要一套簡單的通用元件就能跑任何程式,量產與改良都容易;軟體端,人類累積的全部程式碼都建立在「循序執行指令」這個前提上,新硬體若跑不動既有軟體,等於要求整個產業重學一次。歷史上的挑戰者多數輸在第二件事,輸在效能的反而少。
檯面上的四條路
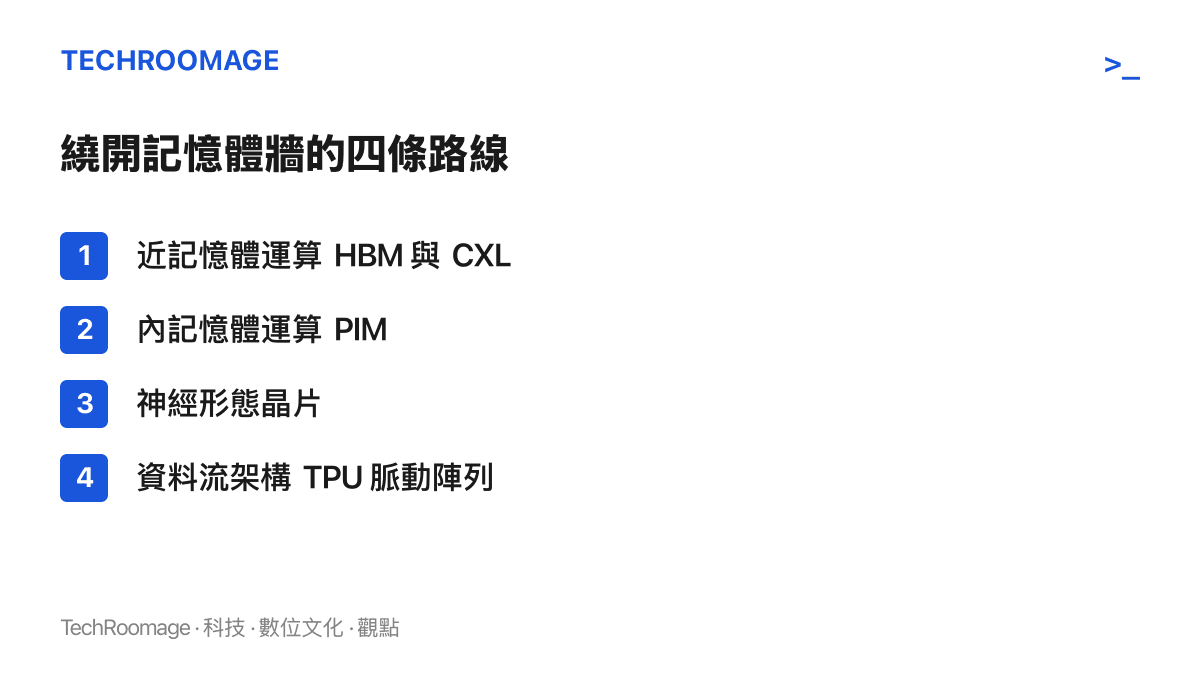
近記憶體運算是目前最溫和的一條。HBM 把記憶體從主機板搬到位在處理器旁的封裝裡;CXL 則是以 PCIe 為基礎的互連標準,讓多臺機器共享一池記憶體。這條路不要求軟體重寫,進度最快,代價是成本與功耗。
內記憶體運算(PIM)更激進,直接在 DRAM 顆粒裡塞運算單元,讓資料原地算完再出門。三星 2021 年發表 HBM-PIM,SK 海力士隨後推出 GDDR6-AiM,新創 UPMEM 已有商用產品。這條路目前卡在程式設計模型:既有的編譯器與軟體生態,很難直接叫得動藏在記憶體裡的運算單元。
神經形態晶片模仿神經元的脈衝通訊,事件來了才運算。IBM 的 TrueNorth 與 NorthPole、Intel 的 Loihi 2 都屬於這一族;Intel 在 2024 年裝進美國桑迪亞國家實驗室的 Hala Point 系統,整合了超過十一億個人造神經元。這類晶片在低功耗推理上潛力明確,距離通用運算還很遠。
資料流架構的代表作是 Google TPU 的脈動陣列:資料像流水般依序流過運算單元陣列,減少回記憶體的往返。它證明了換一種組織運算的方式,可以在矩陣乘法這類工作負載上大勝,而這種勝利屬於分工,需要彈性的部分仍由 CPU 守著。量子電腦也常被放進這類討論,它確實是另一種計算模型,但每一臺量子電腦的控制與糾錯端,目前都靠馮紐曼機器運轉。
你的手機早已是混血
照這個角度看現代手機,畫面其實很清楚。SoC 裡的 CPU 只是其中一員,旁邊站著負責影像訊號的 ISP、跑模型的 NPU、處理圖形的 GPU,這些單元裡有大量固定功能的資料流電路,繞過了「取指、解碼、執行」的老循環。使用者每天拍照、套用模型濾鏡,多數工作已經不走那條八十年的走廊。
所以比較準確的描述是分層:需要彈性、要跑各式軟體的核心仍然是馮紐曼,量大而形態固定的工作交給專用電路。判斷「打破」與否,標準其實落在軟體上,只要開發者寫的仍是循序指令,馮紐曼就還是發號施令的那一層。Backus 在 1977 年問的「程式設計能否脫離馮紐曼風格」,到今天仍是開放問題。
端側 AI 讓這件事更貼身。先前報導過 Opera 要讓模型留在使用者電腦裡跑的 WebAI 計畫,踩的正是同一條界線:模型塞進一般裝置後,記憶體容量與頻寬通常比算力更早見底,架構層的取捨會直接決定哪些應用出得了門。
下一步看什麼
往後聽到任何宣稱「突破馮紐曼瓶頸」的產品或論文,可以先做兩個檢查。第一,程式設計師要怎麼寫?有沒有工具鏈與編譯器,能不能接上既有軟體。第二,它贏的是通用運算,還是特定工作負載。後者比較像又一位專用幫手加入分工,距離換掉地基還很遠。
產業面的訊號可以按時間看。短期看 HBM 的產能與價格,三大原廠的擴產速度,決定「把記憶體搬近運算」這條最溫和的路能走多快;中期看 CXL 記憶體池化在資料中心的實際部署,以及 PIM 從論文變成可下單零件的進度;更遠則看神經形態晶片能否找到第一個大規模的商業場景。哪一項先出現規模化出貨,哪一條路就先從簡報走進機房。
至於那個知乎問題本身,短期答案大概是:體系不會被一根棒子打破,它會繼續被分層、被包圍。真正的格局突變有個前提,出現一套在不犧牲通用性的前提下繞開記憶體牆的計算模型,並長出完整的軟體生態。八十年來還沒有人做到這件事,這也是那個問題還能再掛十年的原因。