 Techroomage
小數點後八位不是證據:BootLoops 要 AI 的科學計算留下可重算的紀錄
當 AI 代做科學計算,答案要能被另一種方法重算才算數,本文以 BootLoops 為例,用廚房比喻說明這套開源工具鏈的驗收流程怎麼運作,並釐清 30 個積分案例與 36 篇稿件為何要分開解讀。
當 AI 開始代做科學計算,重點從「會不會答對」移到「能不能被檢查」。BootLoops 這套開源工具鏈把模型、科學軟體與驗收規則接在一起,讓數字可以被另一種方法重算與比對。
把一條積分丟給聊天機器人,幾秒鐘後它回你一串小數點後八位的數字,版面乾淨,口氣篤定。這串數字可能真的算過,也可能只是看起來像答案的文字。大型語言模型依提示生成內容,它可以把數字直接寫進文字裡,也可以真的呼叫程式去執行;兩種方式產出的數字外觀相同,可追溯的程度卻差得很遠。
十月三日,APPI News 刊出張饒輝介紹 BootLoops 的長文,處理的就是這個落差。BootLoops 是一套開源工具鏈,嘗試把大型語言模型、現成的科學計算軟體、工具文件與驗收規則接進同一個工作流程,讓部分量化計算可以被重複執行,並留下比對依據。
一句話講清楚:給模型一間設備齊全、出餐要過檢查的廚房
BootLoops 官方把它稱為 LLM harness。harness 直譯是馬具,在這裡指包在模型外圍的工具與協調層:模型負責讀工具手冊、寫程式、挑演算法、執行計算並儲存中間產物;每走到關鍵節點,就按研究者事先寫好的測試規則檢查一次。
用廚房來比喻。新廚師手速再快,也不該讓他徒手開罐頭:爐具、量杯、秤、食譜都是現成的(科學軟體與手冊),廚師可以自由組合,但每道菜出餐前要過固定的檢查點,溫度對不對、份量秤了沒。檢查點由主廚設定,廚師換人做,檢查點留下來。官網列出的用途包括計算積分、代數化簡、高精度運算與誤差界定,工具多來自數學、物理與電腦科學領域;這些元件原本散落在不同軟體裡,共同索引與流程降低了逐一拼接的門檻。
流暢的答案沒有檢查入口
模型的輸出再流暢、小數位數再多,都不能單獨當作正確的證據。文字裡列出的數字難以追溯;改用程式執行,輸入、函式、版本與輸出都有了紀錄,多出一條可追的路徑,但程式仍可能寫錯,輸入也可能不合題意。
更麻煩的是問題定義。精確的科學計算要先講清楚數學式、變數與單位、邊界條件、誤差處理。題目描述含糊時,模型可能自行補上條件。一條沒寫清楚積分範圍與精度要求的題目,模型會自己假設範圍與精度,數字照樣漂亮,只是它回答的是另一道題,而後續驗算救不回錯誤的問題定義。這也是 BootLoops 把「模型會不會犯錯」轉成流程設計問題的原因:任務是否適合量化、結果可否交給另一種方法檢查、錯誤發生時能不能定位,這些都能在流程裡事先安排。同一種把主張接到證據上的要求,也出現在我們先前整理的OpenAI 安全案例:每個主張都要附證據與負責人,方向一致:說了不算,要能查才算。
一條積分怎麼驗:兩種算法,加一組沒見過的點
積分是官網最直接的例子。先用直接數值積分取得近似值,再用解析式或另一種演算法計算同一個函數;結果在預定精度內吻合,就多了一項計算一致的證據。BootLoops 官方介紹還提醒一個細節:用未參與擬合的測試點檢查結果,降低程式只對已知答案調參數的風險。這很像防止背題的考試,題卷裡一定要有幾題補習班沒教過的新題,否則高分可能只是默寫。
交叉比對仍有極限。兩種方法可能共享同一個錯誤假設或同一份錯誤輸入,數字對得上,題目本身仍可能是錯的。數值檢查也回答不了模型適不適用、資料能不能代表研究對象、結果有沒有領域意義。計算正確性、研究設計與科學解釋是三個不同層面的問題,各自需要不同的檢查者與證據。代理工具的輸出要回到逐筆比對,我們在MCP 代理的來源驗證要逐份文件對帳也遇過同一道關卡。
30 個案例與 36 篇稿件,成績要分欄看
Anthropic 的文章提到 BootLoops 跑通了 30 個端到端積分案例;同文另一處提到三個月內產出 36 篇稿件,涵蓋 18 個領域。兩個數字常被讀成同一件事,其實欄位不同。積分案例走完了從出題到驗收的完整流程,是可重算、可比對的計算成果;稿件是模型參與產出的文件,三個月 36 篇說明產出速度與廣度,但稿件數量本身不能當成研究成果已通過驗證的證據。稿件要成立,還需要同儕審查等別的機制接手,那是另一套檢查。
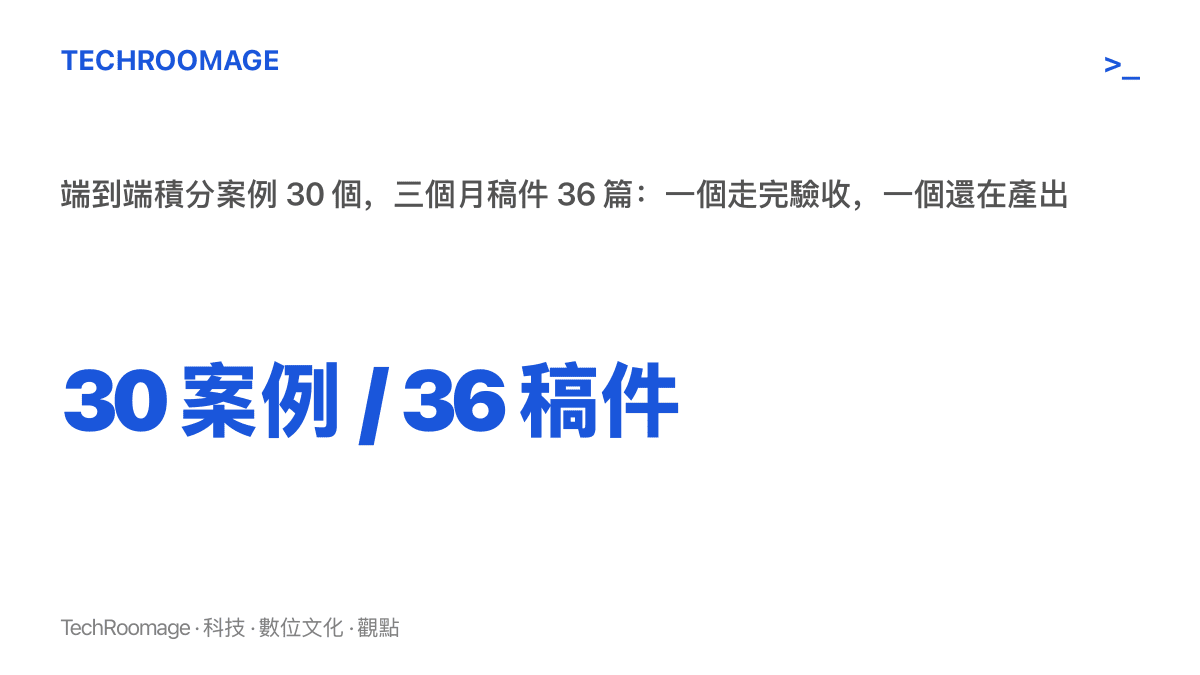
這也是讀 AI for science 新聞時最值得多看一眼的地方。產量與驗證是兩個欄位,把它們併在同一格,帳就會算錯;一個計畫可以同時跑出很多稿件與很少通過驗收的案例,兩件事都真實存在。
導入之前,先檢查這幾件事
開源兩個字也要分開檢查。程式碼拿得到,不代表每個相依套件的授權條款相同,也不代表安裝、運算與維護沒有成本。採用前值得逐一確認:工具與模型服務的授權、支援的作業環境、運算資源需求,以及既有研究程式要不要搬進新流程。張饒輝在文中給了一個務實的判準:文件能不能讓人重現安裝與執行步驟,常比「開源」兩個字更能決定日後能不能交接。
BootLoops 的框架與底層模型是分開的,Claude、Gemini、ChatGPT 都可以使用,模型可替換,工具與驗收方式持續維護,這降低了流程綁死單一模型的程度。可替換也不代表表現相同,團隊仍要為使用的模型、提示內容、工具版本與運算環境留下紀錄,否則換模型之後的結果落差會變成無從解釋的謎。至於驗收條件,測試點、誤差上限、失敗的定義與停止規則,始終是人的工作,工具只負責執行。
帶走三個問題
下次再看到 AI 完成科學計算的消息,可以先問三件事。答案能不能用另一種方法重算?比對基準夠不夠獨立,有沒有用沒見過的測試點?新聞裡的數字屬於驗收過的案例,還是產出中的稿件?三題都答得上來,再決定要相信幾分。這波 AI 進入科學計算的真正考題,在於答案能不能被檢查;算得快這件事,機器早就拿滿分了。接下來值得盯的訊號也清楚:除了積分,物理與化學等領域什麼時候出現走完同樣驗收流程的可重算案例,那才是這條路線的進度條。
資料來源:本站編輯參考 APPI News〈AI 科學計算能信嗎?BootLoops 如何驗證結果〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。