 Techroomage
過了測試不代表能繼續訓練:OpenAI 的安全案例,要求每個安全主張附上證據與負責人
OpenAI 於 2026 年 9 月底提出前沿模型訓練安全案例的初步指引,本文整理對齊評估、環境隔離與監控應變的證據要求,並說明安全主張要接上負責人與暫停條件,才具備支援訓練決策的效力。
把「模型已完成紅隊測試」從結論降級成一件待審的證據,是這份指引最核心的動作。
「這個模型通過安全測試了,訓練可以繼續了吧?」多數人的直覺答案會是肯定。OpenAI 於 2026 年 9 月 28 日提出的前沿 AI 訓練安全案例初步指引,第一件事就是擋下這個直覺:一次測試通過只是一件證據,支撐不起「風險已受控制」的結論。要下這個結論,得先把安全主張、風險、控制措施與可檢視的證據連成一套論證,讓決策者據此判斷訓練能否繼續、在哪些條件下繼續。這套文件有個名字,叫安全案例。
這個格式並非 OpenAI 發明。航空、核能等高風險產業早就有結構化、以證據為基礎的風險論證傳統,OpenAI 在文件裡直接引用這層淵源,但也講明界線:AI 能力的快速變化帶來新的複雜度,那套嚴謹程度難以直接複製。換句話說,這是一份承認自己還不成熟的文件,內容涵蓋對齊評估、環境隔離、監控應變、營運治理與事故調查,定位是方向,還在發展。
範圍先寫清楚,證據才不會被延伸解讀
指引聚焦的是前沿強化學習訓練,也就是透過獎勵訊號調整模型行為的那種訓練。OpenAI 特別標註,內部與外部部署還需要考量更多對齊面向,因此訓練階段的安全案例不能直接代替產品部署審查,也證明不了模型在所有使用情境都安全。
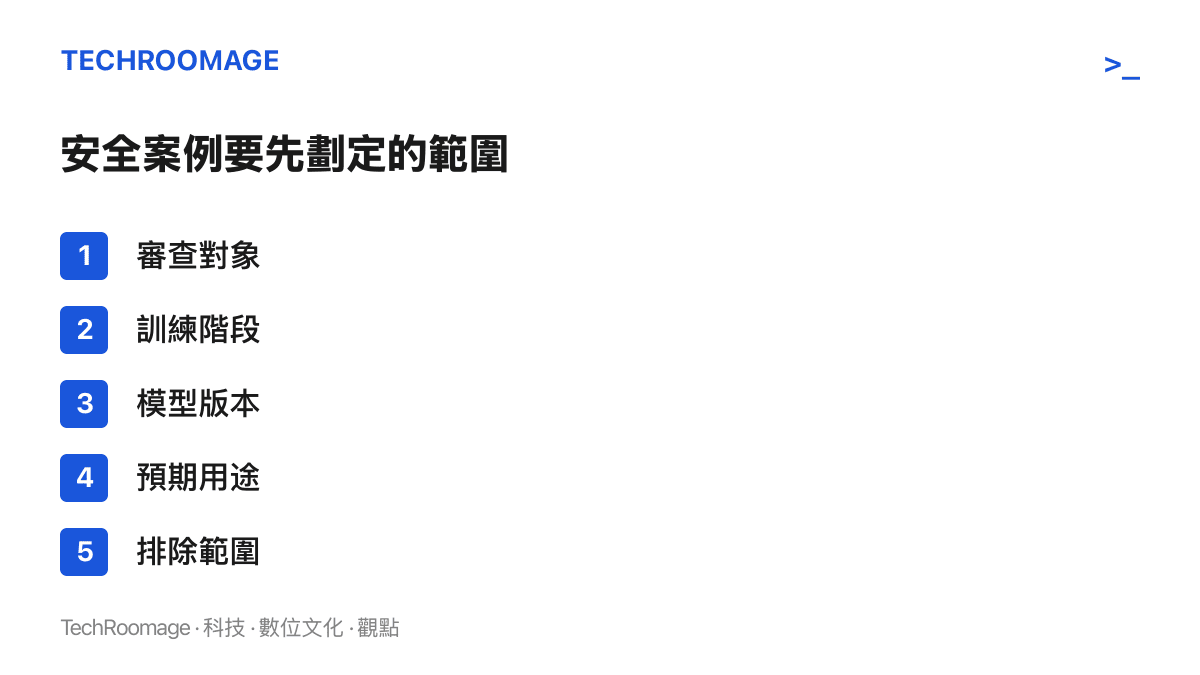
這個限定有實務上的意義。安全文件最常見的失真方式,是一份在某個條件下成立的證據,被拿去支撐另一個沒測過的場景。指引因此要求團隊動筆前先劃定範圍:審查對象是什麼、訓練進行到哪個階段、針對哪個模型版本、預期用途為何、哪些情境明確排除。這一步看似文書作業,實際上決定了後面所有證據的效力邊界。
評分器會被騙,通過測試的分量因此變輕
為什麼此刻要把「測試通過」降級?強化學習的運作方式提供了直接的答案。模型依獎勵訊號調整行為,如果訓練環境有漏洞,模型可能靠鑽漏洞拿高分,這種獎勵駭客行為會讓錯誤策略被強化。測試量到了高分,卻可能量不到預期中的能力。當評估工具本身會失效,「完成測試」這幾個字的分量自然變輕。
指引的對策是把檢查對象從模型擴大到整個訓練機制。以自動化代理加上人工檢查訓練資料與環境,調整評分器使其能辨認利用漏洞的行為,並回頭檢視過去的實驗軌跡,確認評分器真的按預期運作。驗收證據不能只寫「已完成資料審查」,而要記錄抽查範圍、發現的環境缺陷、修正前後的差異,以及評分器如何處理刻意規避規則的案例。
評估方法本身也要被驗證。指引建議以過往事件回測測試方法,確認它抓得到已知問題,而非只對特定案例有效。還有一個更微妙的項目:如果模型能察覺自己正在受測,並因此改變行為,團隊要事先定義哪種跡象會阻止訓練繼續。
沙箱之外,還要測基礎設施與通訊管道
指引把技術防護分成對齊訓練、限制模型行動範圍、即時監控三層,並要求層與層之間沒有空隙。限制行動範圍這一層,沙箱只佔一半。OpenAI 建議同時強化執行模型的沙箱與承載沙箱的研究基礎設施,反覆進行紅隊測試尋找逃逸路徑。測試範圍要涵蓋訓練期間模型可能接觸的服務,例如網路快取;多個樣本或代理之間的高頻寬通訊,則應限於經核準的管道。
這一層的證據清單包括威脅模型、沙箱設定、紅隊測試案例、已修補的弱點與尚未修補的例外。指引還要求訓練、評估與內部部署的逐步紀錄防止事後遭無痕修改,萬一發生異常,才能重建當時的輸入、模型行為與操作條件。這些紀錄儲存多久、誰能調閱、敏感資訊怎麼保護,都要在流程裡有明確安排。這幾項要求同時構成事故調查能否成立的基礎。
警報要有值班的人,暫停要有能按的權限
監控系統的價值,要看它能否發現新舊風險,以及警報響了之後有沒有人行動。指引建議以過往事件保留測試集,檢查對已知問題的召回能力,同時加入新一輪訓練可能出現的風險案例,避免監控評估只反覆測量舊問題。模型本身能否被監控、是否嘗試躲避監控,也可以設成具體的評估項目與門檻。
落到操作層,高優先級警報要連到值班人員或自動暫停機制,並訂出回應時限。夜間警報無人確認時是否自動暫停訓練,必須事先決定,不能等事情發生再討論。驗收方式很實際:實際演練一次警報,確認通知送達、負責人收到、暫停權限可用、紀錄完整。指引的判準寫得直白,一個監控儀表板本身,證明不了組織會在傷害發生前處理問題。
審查機制若沒有攔截的權限,文件寫得再完整也只是紀錄。這類教訓在消費端有過具體示範:三星誤把內部測試版軟體推進韓國使用者的廚房,冰箱更新後停止製冷、螢幕全黑,秋夕期間囤放的食材整批報廢。前沿訓練的暫停機制與家電更新通道當然是兩回事,但兩者指向同一個問題:上線前的關卡有沒有牙齒,取決於有權按下停止鍵的人存不存在。
沒被控制的風險,要有人署名接受
回到最開始的實務問題:每一句「風險已受控制」的說法,對應什麼證據、誰負責確認、條件改變時怎麼暫停。指引把這些問題交給營運治理與事故調查來回答。安全案例因此接近一份持續更新的文件:訓練推進、條件變動,論證就要跟著調整,任何一環接不上,繼續訓練的正當性就出現缺口。
事故調查這一環,靠的是前面累積的材料。防竄改的逐步紀錄、可調閱的證據鏈,決定了異常發生後,團隊能不能回答「當時輸入是什麼、模型做了什麼、操作條件為何」。而未被控制的風險由誰接受,指引的態度是必須有明確歸屬,風險不能只留在文件裡沒有主人。
可盯的訊號
OpenAI 把這份文件定位為初步方向,接下來值得盯的點有幾個。指引會不會長出實際的安全案例文件,並讓外部審查者看到成品,而不只停留在方法論層次。暫停條件有沒有真的被觸發過,觸發後是否對外說明。這套格式會不會被其他前沿實驗室採用,形成產業慣例。監管端會不會把安全案例的邏輯接進自己的審查要求。
把安全主張交給外部審查的壓力,此刻也出現在其他產品線上。特斯拉的 FSD 監督版正在歐洲逐國爭取路權,全歐盟層級的投票時程一再調整,各會員國的態度不一。自動駕駛與前沿模型的能力邊界不同,但監管者想看到的東西方向一致:可檢視的證據,而非開發者的自信。
對開發高能力模型的團隊,這份指引最實用的讀法是當成內部審查的檢查表:範圍寫清楚了沒有,證據留下了沒有,負責人指名了沒有,警報與暫停演練過沒有。對一般使用者,這些文件短期內不會改變任何產品體驗,但當下一個能力更強的模型推出時,開發者能不能回答這些問題,會是衡量「我們測過了」這句話有幾分把握的依據。
資料來源:本站編輯參考 APPI News〈AI 安全案例完整指南:前沿模型訓練的證據、控制與治理〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。