 Techroomage
省下的是記憶體,賠上的是長對話:Seed 論文點出 DeepSeek 的性能漂移
字節 Seed 團隊九月底提交的論文近日在知乎掀起討論,本文從傳播時間差、壓縮稀疏注意力的取捨邏輯與評測方法缺口,整理性能漂移對使用者、開發者與模型廠的意義與後續可驗證訊號。
字節 Seed 團隊九月底的論文,近期在知乎再掀討論:壓縮稀疏注意力讓長上下文出現性能漂移,一份由競爭對手執筆的診斷,同時暴露了評測方法的缺口。
晚了兩週才發燒的論文
9 月底,字節跳動 Seed 團隊把論文《Periodic Weak Spots》提交到 arXiv,結論後來被濃縮成一句話在工程圈流傳:以 DeepSeek V4 系列為代表的模型,使用壓縮稀疏注意力,會在長上下文場景發生性能漂移。當時的討論集中在論文與開發者社羣。這幾天,知乎出現「如何評價字節 Seed 團隊發現 DeepSeek 性能漂移」的提問,才把這份研究推到更廣的使用者面前。
傳播上這兩週的時間差本身有故事。一篇論文要變成公共話題,中間通常得先有人重現結論,再有人把它轉譯成白話。這次還多了一個放大器:DeepSeek 的使用者基數大,長對話與文件問答又是高頻需求,論文描述的現象許多人親身遇過,缺的只是一個名字。性能漂移四個字補上了這個空位,把「這模型好像不太穩」的模糊抱怨,換成可以指認、可以測量、也等於可以要求修復的工程問題。
漂移從哪裡來:省記憶體的代價
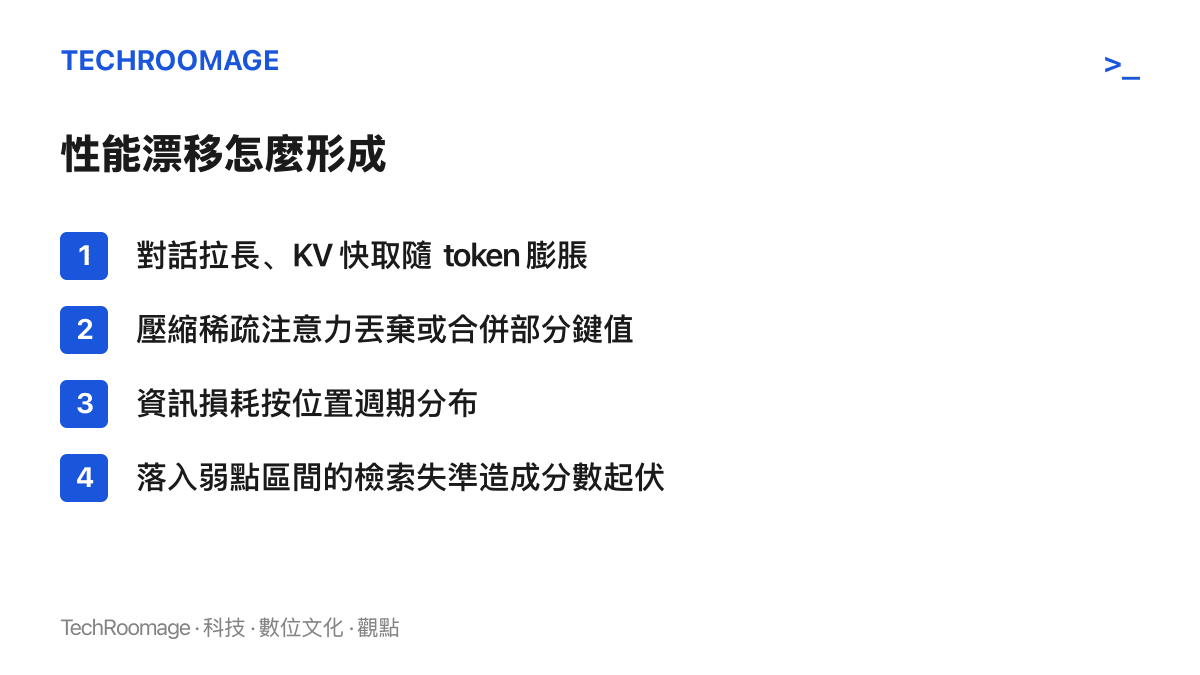
長上下文昂貴的原因相當具體。模型每讀進一個 token,就得記下一組鍵值,對話越長,這份 KV 快取越大,記憶體與計算開銷同步上升。壓縮稀疏注意力是常見的省法:丟棄或合併部分鍵值,讓注意力只看精簡後的歷史。記憶體的帳省了下來,資訊卻有了損耗。
用圖書館來比喻。為了省書架,館方把舊期刊每隔幾冊裝訂成一冊摘要,原文只保留其中一部分。查近期的文章沒有問題,但想找一篇剛好落在被摘要掉的那一冊裡的舊文,就會撲空。Seed 團隊的發現在於,這種損耗帶有位置規律,按週期分布。資訊落在弱點區間,檢索就失準;落在區間外,一切如常。反映到使用端,就是同一個模型、同一類任務,分數隨上下文長度與資訊所在位置起伏。
還要留意論文的寫法:它以 DeepSeek V4 系列為代表案例,指向的卻是壓縮稀疏注意力這條技術路線的通性。追求更長視窗、更低成本的模型多半走上同類工程取捨,採用相似做法的模型,理論上都值得同一套檢驗。本站在論文發布當週已從技術面寫過這套機制,當時的切入是DeepSeek 時靈時不靈,出在壓縮記憶體那一步,這裡換個角度,看它對產業的意義。
誰付出代價
一般使用者是最先碰到問題、也最難歸因的一羣。把整份文件交給模型、或連續追問十幾輪之後,答案開始不可靠,過去這種體感常被歸咎於自己的問法。論文給出的解釋把一部分責任還給架構。在模型端更新之前,使用者能做的繞路包括:把關鍵資訊放在貼近提問的位置、長對話適時重開,降低資訊落入弱點區間的機率。
應用開發者承受的商業壓力最直接。RAG 與代理型應用會把檢索結果、工具輸出與歷史對話大量裝進視窗,等於把產品穩定性押在模型的長上下文品質上,而且按 token 計費的結構下,塞得越多、付得越多,買到的檢索品質卻隨位置打折。單次測試跑通說明不了什麼;同一份文件換位置提問、同一組測資重複抽樣,漂移才會現形。這也是把 AI 應用品質變成可反覆比較的成績單這類評測工具存在的理由,先留下每次執行的現場,才談得上改進。
模型廠與評測生態面對的則是方法論缺口。現行榜單多以單次或平均分數呈現能力,週期性的弱點會被平均掉:弱點區間丟掉的分,被正常區間補回來,榜上依然體面。Seed 團隊示範的另一種做法,是按位置掃描、按重複次數看變異。至於論文出自 DeepSeek 的直接競爭對手,這層關係值得攤開來讀:公開且可重現的研究值得肯定,發布者的位置也提醒讀者,結論要靠獨立驗證,而非照單全收。競爭對手互寫診斷書,短期看是火藥味,長期看是這個行業少數健康的壓力來源。
接下來可以盯的訊號
後續幾個月,有幾件事可以驗證這篇論文的份量。一看 DeepSeek 的回應方式:調整壓縮策略、在文件裡標示長上下文的適用邊界,或提出資料反駁,都算正式回應,沉默則是另一種答案。二看第三方重現:獨立團隊用自己的測資跑出同樣的位置效應,結論才會從單一團隊的主張變成產業常識。三看榜單變化:位置敏感度與重複測試變異數若開始出現在長上下文評測,代表方法論真的被聽進去了。
對開發團隊來說,還有一個不必等任何人的動作:把多次抽樣與位置掃描寫進選型流程。這不依賴模型廠的時程,今天就能做,而且做一次就知道手上的應用對漂移有多敏感。
給一般讀者的判斷可以收斂得很簡單。長上下文的行銷數字年代,單一高分的資訊量只會越來越低,下一次看到「支援百萬 token」的宣傳,先問兩件事:穩定性資料在哪裡,測試重複跑了幾次。這篇論文把弱點寫成白紙黑字的價值正在這裡,它沒有替任何一家定勝負,卻給了所有為長上下文付費的人一套問問題的方法。