 Techroomage
時靈時不靈有了解釋:DeepSeek 的「抽風」,出在壓縮記憶體那一步
以字節跳動Seed團隊今年9月底提交的arXiv論文為起點,說明分塊KV快取壓縮帶來的相位敏感性如何讓長對話檢索時好時壞,並整理使用者可以依序調整的應對方式。
9 月底的一篇論文,把 DeepSeek 使用者回報已久的「抽風」連到分塊 KV 快取壓縮的相位敏感性:同一份資訊落在不同階段,檢索難度跟著不同,準確度落差最高可達 40 個百分點。
把一份幾十頁的文件貼進 DeepSeek 的對話框,問它文件中段提到的一個數字。第一次,它答得又快又準;重新開一個對話、放同一份文件、問同一個問題,它回你一句「文件中沒有這項資訊」。這種時好時壞的表現,使用者社羣給了一個口語名字:抽風。
今年 9 月底,字節跳動 Seed 團隊在 arXiv 提交論文,給了這個現象一個技術解釋。這則發現最近經由百度熱搜的詞條「DeepSeek『抽風』原因曝光」再被翻出來討論,讓非技術背景的使用者第一次有機會看懂:模型的「忘記」,可以追溯到一個非常具體的工程決定,壓縮記憶體。
先講一句話版本
DeepSeek 採用的分塊 KV 快取壓縮,能大幅降低記憶體成本,代價是引入了「相位敏感性」:同一份資訊落在不同階段,檢索難度不一樣。在採用這類壓縮的大型模型上,長上下文檢索準確度在各階段之間的落差,最高達 40 個百分點。
這句話裡的每個名詞都值得展開,因為它們共同回答了使用者在深夜對話框前最常冒出的疑問:到底是我問得不好,還是模型壞了?很可能兩者都不是,問題出在模型的記事方式。
模型的辦公桌上,有一本越來越厚的筆記
大型語言模型的注意力機制,每生成一個字,都要回頭查閱前面所有看過的內容。為了避免每一步都重算,模型會把每個字詞對應的「鍵值」存下來,這就是 KV 快取。可以想成開會時的逐字稿:與會者每講一句話,都要能隨時翻回前面任何一頁,確認誰說過什麼。
會開得越久,逐字稿越厚。對話來到數十萬字時,這本筆記的體積會喫掉大量繪圖卡記憶體,而記憶體恰恰是推論成本裡最貴的項目之一。服務要同時應付幾十萬個對話,每個對話各帶一本厚筆記,硬體開銷會直接失控。
因為記憶體壓力而調整工程優先順序的,也不只 AI 這一行。微軟近期就因為記憶體漲價,讓 Win11 從自己身上省 RAM,把降低系統記憶體佔用列為階段重點。差別在於,作業系統省記憶體影響的是流暢度,模型壓縮記事影響的,是它記不記得你說過的話。
DeepSeek 的體量讓這件事被放大。這家公司 2023 年 7 月由量化基金幻方量化孵化,2025 年 1 月推出開源推理模型 R1 之後,App 曾同步登上中美兩地應用商店免費榜首位。免費、開放、使用者基數大,長對話自然多,「抽風」的體感回報也就格外密集。
壓縮登場:把逐字稿分批濃縮
工程師的解法是壓縮 KV 快取。DeepSeek 走的是分塊壓縮:把逐字稿切成一段一段,每一塊壓縮成更小的表示,再存進記憶體。省下來的空間非常可觀,這類壓縮因此成為大型模型控制推論成本的常見手段。
但壓縮是有損的。論文的核心發現是,這種分塊壓縮會帶來「相位敏感性」,資訊被找回來的難易,取決於它落在壓縮過程的哪個位置。
一個貼近生活的比喻是影印裝訂好的文件。同一行字,落在頁面中央,影印得清清楚楚;落在靠近書脊的裝訂邊,就被壓得歪斜模糊。字沒有變,內容沒有變,變的是所在位置決定了它被複製後的可讀性。相位敏感性的作用類似:你的資料本身完好,但它落在「裝訂邊」的時候,模型讀它就是比較費力。
這也解釋了「抽風」為什麼看起來隨機。使用者看不到自己的資料落在哪個相位,只看得到結果:有時秒答,有時裝作沒看到。同一份文件、同一個問題、兩個對話,答對與答錰的差別,可能只是重新上傳之後,那句關鍵話換了個位置落座。
40 個百分點是什麼概念
換個方式感受這個數字。一個學生考第三章的題目拿了九十分,考第七章幾乎相同難度的題目卻只有五十分,你會懷疑他讀書有嚴重盲區。模型也一樣:平均分數可能漂亮,但平均把波動藏起來了。評測若只抽幾個位置出題,剛好抽到「頁面中央」,得到的印象就會過分良好。
還有兩點值得放在天秤上。第一,論文的檢驗對象是「採用此類壓縮的大型模型」,DeepSeek 只是其中最受矚目的一個,這是技術路線層級的問題,不是單一產品的瑕疵。第二,提出診斷的是字節跳動的 Seed 團隊,同賽道的競爭者。AI 研究圈並不罕見這種跨公司診斷,方法公開、可檢驗,這篇論文的結論能否被其他團隊複現與修正,值得持續追蹤。
對依賴長上下文的應用來說,這個發現分量更重。從文件分析到讓模型自己連跑幾十步的代理任務,都建立在「模型能穩定找回早先資訊」這個假設上。當找回的可靠度隨位置劇烈波動,應用端就需要自己的驗收方法,這與我們先前介紹過的LangSmith 替 AI 應用留現場、發考卷的思路相通:檢索品質要被量測,不能被假設。
使用者端可以調整的四個動作
在模型端的修正到來之前,日常使用有幾個調整方向。
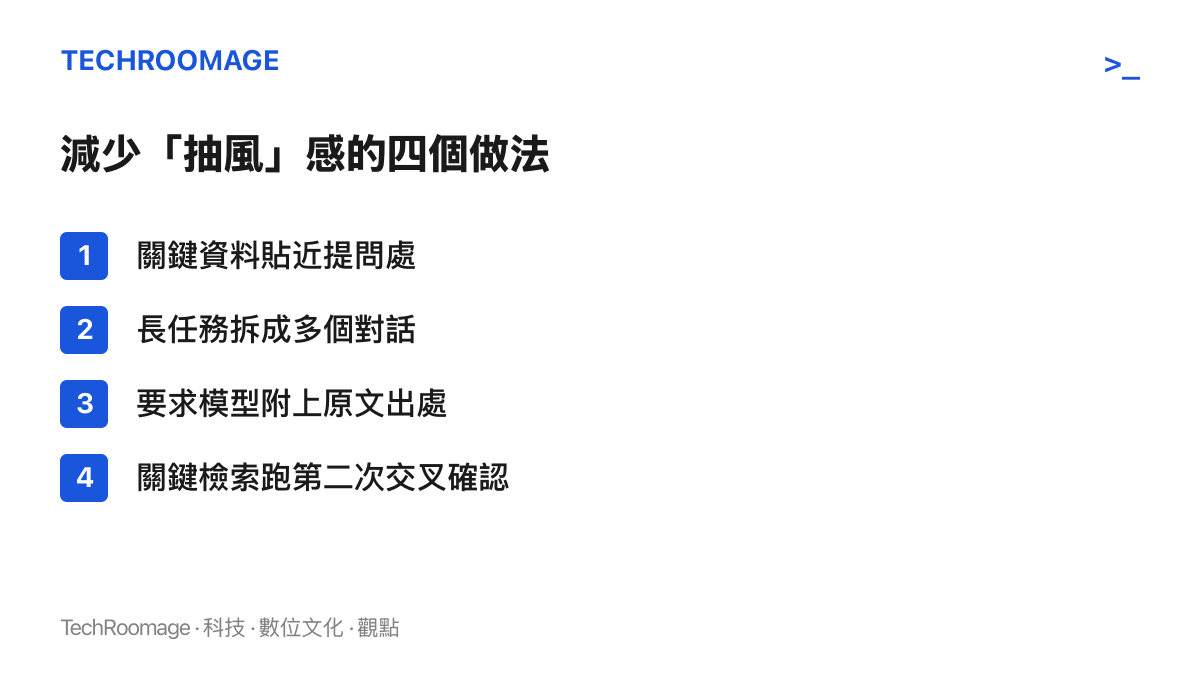
一是把關鍵資料放得離提問近一點。對話尾端的資訊離查閱點最近,檢索負擔最小;幾十頁的文件與其一次傾倒,不如在提問前把關鍵段落重新貼一次。二是超長任務拆對話。同一個話題開新視窗,筆記變薄,位置帶來的亂數影響跟著變小。三是對重要結論要求附出處。請模型引用原文段落再作答,核對的工作從「相信它」變成「對答案」,抓錯的機率自己會現形。四是成敗關鍵的檢索跑第二次。成本多一輪對話,但位置換過一輪,兩次都對的答案,可信度明顯不同。
接下來值得盯的訊號
短期看 DeepSeek 與其他採用同類壓縮的模型,是否在後續版本用訓練或推論策略壓平這種位置間的落差。修正未必代表放棄壓縮,也可能是在壓縮框架內補償那些敏感相位。
中期看評測慣例。長上下文評測若開始分位置報告變異,而不只給一個平均分,這類問題會更早被看見。平均分掩護盲區,變異才會暴露盲區。
至於一般使用者,下次模型又忘了你幾個小時前說過的話,先別急著改寫問法。把那句話再貼一次,放在離問題近一點的地方,多半比換十種措辭有用。知道麻煩出在哪一步,應對就可以很具體。