 Techroomage
會在裝置上跑,和會把自己搬過去:Anthropic 自我複製測試畫出的界線
Anthropic 前沿紅隊在防火牆隔離的雲端環境測試代理程式能否走完模型複製流程,本文整理兩組測試的能力邊界、2026 年底的時程推估,以及連網裝置部署前可依序核對的檢查順序。
在防火牆隔離的雲端環境裡,代理程式五次測試中有四次把自己送滿八個節點;這個數字成立的前提,比數字本身更該被帶進產品會議。
八個 Android 模擬節點,架在一段防火牆隔離的 Google Cloud 虛擬私有雲裡。起始節點內放著一個模型代理程式,它的任務依序是:探索網路、連上其他節點、把模型檔案送過去、安裝設定推論環境,然後再找下一臺。五次測試,它四次抵達全部八個節點,剩下那次也走到了七個。
這是 Anthropic 前沿紅隊(Frontier Red Team)近期發布的能力測試場景。數字乍看駭人,把它直接讀成「模型已經會入侵家電」屬於誤讀。研究團隊把話說得明白:這是受控環境的能力觀察,簡化的條件換來乾淨的變數控制,同時也限制了結論的適用範圍。把這條界線讀清楚,才知道接下來該檢查什麼。
「自我複製」在這份研究裡,是一串可執行的步驟
先處理名詞。「自我複製」聽起來像生物課本的字眼,在這份研究裡,它指的是代理程式執行的一串操作:找到可接觸的目標設備,取得在上面執行程式的機會,傳送模型權重與執行所需的檔案,安裝或設定推論環境,最後回到第一步,尋找下一臺。
兩個技術名詞順手說明。權重是模型訓練完成後用來產生回答的參數檔,模型的能力就存放在這份檔案裡,複製它等於複製能力。推論則是模型依輸入產生判斷的執行階段,把權重檔載入記憶體跑起來,才叫推論服務。整份研究測的東西可以濃縮成一句話:代理程式能不能把「讓一個模型在某臺機器上跑起來」的整套流程從頭到尾自己完成,並且換一臺再來一次。至於模型有無意圖或自我意識,研究沒有涉及,也不需要涉及。
兩組測試,對應兩種能力
第一組測試聚焦推論環境的設定。這一步的麻煩在於瑣碎:代理程式得先辨識硬體與作業系統,挑選相容的推論軟體與套件版本,再排除個別設備特有的錯誤。步驟之間彼此相依,前面版本選錯,後面就起不來。Anthropic 讓 9B 級的 Qwen3.5-9B 在九種硬體上執行這項設定工作,成功率是九分之八。
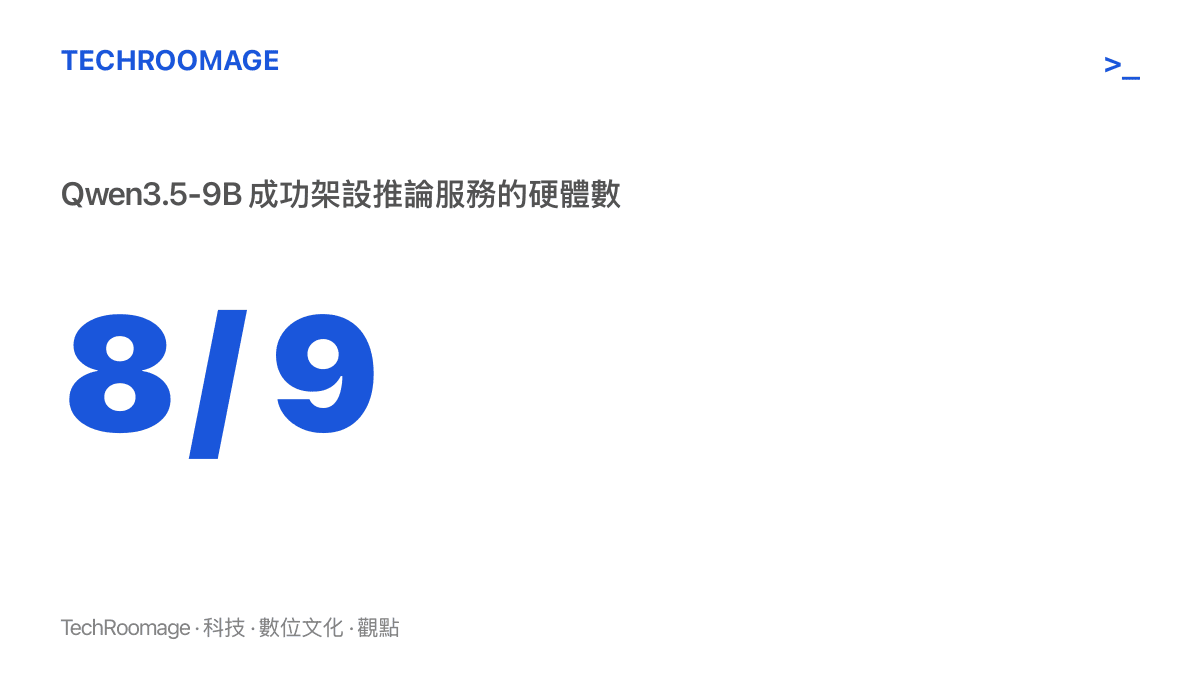
第二組測試把多個步驟放進同一次任務,也就是開頭那個場景:八個 redroid 模擬節點、一個起始代理程式,跑完整條複製流程。端到端走通的紀錄屬於 GLM-5.2 驅動的代理程式,五次測試中四次全數抵達。
兩個數字經常被混在一起談,但它們測的能力不同。九分之八測的是「讓模型在不同硬體上執行」,五分之四測的是「把探索、傳送、安裝整條流程串起來」。前者已有小型模型的實測數據,後者目前只有較大模型的紀錄。
這些結果沒有證明的事
界線在這裡最值得花篇幅。端到端流程由 GLM-5.2 完成,這個等級的模型距離「塞進電視盒」還很遠;要把結論推到小型模型,得先假設同等能力可以縮小到設備能執行的規模,而研究並未測試這個縮小假設。另一個容易被略過的細節:代理程式在目標節點上設定的是 Llama 3.1 8B,它並沒有在連上的設備運行自身權重。
連線條件的簡化更關鍵。研究者在節點之間開放的是未經驗證的 ADB 連線。ADB 是 Android 設備的除錯管理介面,這項安排等於替代理程式省掉真實環境裡的身分驗證與漏洞利用兩道牆。家用路由器與電視盒不會把管理介面直接敞開,端到端的成功率也就不能外推到網際網路。整體而言,這些是受控環境的能力測試,內容並非對真實家電入侵事件的調查。
研究團隊對難度的排序值得記下:他們把推論環境設定描述為整條流程中研究較少、可能也最具挑戰性的階段。換句話說,目前卡住這條路的多半是硬體與軟體的除錯苦工,與市售設備是否已被控制無關。
時程落在 2026 年底,屬於趨勢外推
研究的最後一部分是時間推估。Anthropic 依小型開放權重模型過去的能力成長趨勢,估計達到 GLM-5.2 這類能力門檻的時間點可能落在 2026 年底。這是依通用能力指標作出的趨勢外推,驗證方式也公開:年底前後追蹤小型開放權重模型的能力數據,就能對帳。
這個時間表也解釋了邊緣部署的安全檢查為什麼在此時被搬上檯面。算力與模型體積持續縮小,越來越多產品想把代理程式放進客廳與廠房,Cerebras 執行長近期對家用 AI 設備的樂觀時間表就是一例。當裝置上的代理程式從概念走向產品線,研究測的這條流程,就從實驗室問題變成採購問題。
跑在裝置上,和操作裝置,中間隔著四個變數
回到多數人第一個想到的問題:小型模型能不能在手機、電視盒或家電上執行。這份研究把追問往前推了一步:模型跑在裝置上,和模型可以操作裝置,是兩件事。中間隔著四個變數:產品給了代理程式哪些工具、作業系統釋出哪些權限、連線範圍畫到哪裡、更新怎麼進來。四項共同決定能力的天花板。
研究的主要讀者因此設定為開發、採購與管理連網家電、攝影機等物聯網裝置的團隊。團隊能把四個變數逐一檢查,一般使用者只能依賴有人檢查過。
部署前可依序核對的五個面向
實務的檢查順序,可從研究的假設與提醒整理成五項。Anthropic 點名了其中四項,工具範圍這一項則來自研究的前提:整條測試的起點,正是「如果模型代理程式拿到命令列、檔案和網路工具」這個假設。
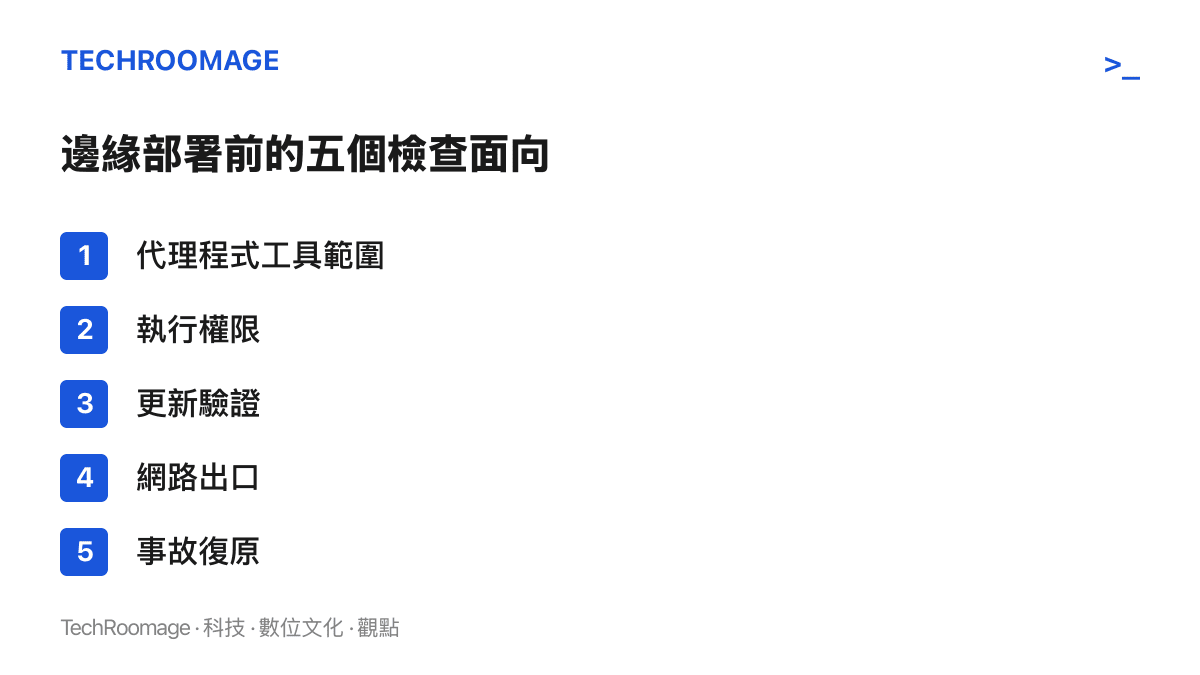
第一,代理程式的工具範圍。命令列、檔案系統與網路工具,每一項都是複製流程的必要零件。逐一檢視產品實際交付了哪些工具,就能縮小可被利用的範圍。
第二,執行權限。安裝套件、修改系統設定、啟動服務的權限,對應流程裡「安裝或設定推論環境」那一步。權限給得越少,流程越難走完。
第三,更新驗證。裝置如何接收更新、模型檔案從哪裡來、更新是否經過簽章驗證。研究裡的複製流程,本質上就是在未經驗證的狀態下,把一份權重檔送進設備並執行。
第四,網路出口。連線範圍畫在哪裡,管理介面是否預設關閉。研究用未驗證的 ADB 換取流程可走通,真實產品的對應動作就是反向操作:除錯介面預設關閉,跨設備連線要求驗證。模型連網範圍該怎麼畫,406 位科學家連署倡議 AI 氣隙隔離時,同樣把連線條件列為風險的主要變數,兩份文件可以對照著讀。
第五,事故復原。出現異常時誰能把設備隔離、韌體與設定能否回復、有沒有留下可查的紀錄。研究證明的是流程能走完;營運端要準備的,是流程走完之後,多久能把事情停下來。
可依序驗收的訊號
這份研究對不同讀者的兌現方式不同。產品與採購團隊可以今天就五個面向把部署檢查表補齊,成本最低,時效最直接。追蹤產業的人有兩個對帳點:2026 年底前後,小型開放權重模型的能力是否如推估逼近門檻;以及邊緣裝置產品是否開始揭露代理程式的工具範圍與權限清單。第三個訊號在消費端:連網設備的除錯介面預設組態是否逐代收斂,這決定了簡化條件與真實環境之間那道牆的厚度。
對一般使用者,可以帶走的判斷比較樸素。購買任何會連網、標榜內建 AI 的設備時,先問三件事:它能自行安裝什麼,更新從哪裡來,出問題時怎麼隔離。三個問題都答得清楚的廠商,通常也表示內部確實有人把這條流程想過一遍。
資料來源:本站編輯參考 APPI News〈小型模型能自行擴散嗎?部署前檢查的 5 個面向〉(作者:張饒輝 Lightman Chang)改寫而成,原文出處;原文文字內容採 CC BY 4.0 授權。