 Techroomage
OpenAI 教 GPT-6 別說廢話,29.4 萬字的內部指令先一步外流
編碼模型 GPT-6 Sol Codex 的完整系統提示詞與工具定義被放上 GitHub,1,902 行內容首度公開 OpenAI 以負面詞彙黑名單、高自主性條款與定時回報紀律塑造代理行為的完整做法。
一份 1,902 行的文件規定了 GPT-6 Sol Codex 說話的方式與停手的時機;它隨每次對話進入使用者的上下文,也因此在被放上 GitHub 之後,任何人都能逐行閱讀。
10 月 5 日,在 AI 社羣以提取各家系統提示詞聞名的研究者 elder_plinius,將 OpenAI 現役編碼模型 GPT-6 Sol Codex 的完整系統提示詞公開到 GitHub 的 CL4R1T4S 儲存庫。全文 1,902 行、約 29.4 萬字元,連同工具定義一併釋出,IT之家等媒體當日跟進報導。
這份文件並非過時舊物。GPT-6 Sol Codex 是 OpenAI 現役 GPT-5.6 Sol 產品線的主力編碼模型版本,內容涵蓋指令模板、臨時指令檔與內部協作邏輯,正是這套編碼代理的完整行為準則。製藥廠可以把配方登記為營業祕密、留在廠房裡;大模型的行為準則卻必須在每次工作階段開始時送進上下文。模型讀得到,就代表使用者端摸得到,這次外流只是又一次印證。
一張負面詞彙表,和「不準強顏歡笑」
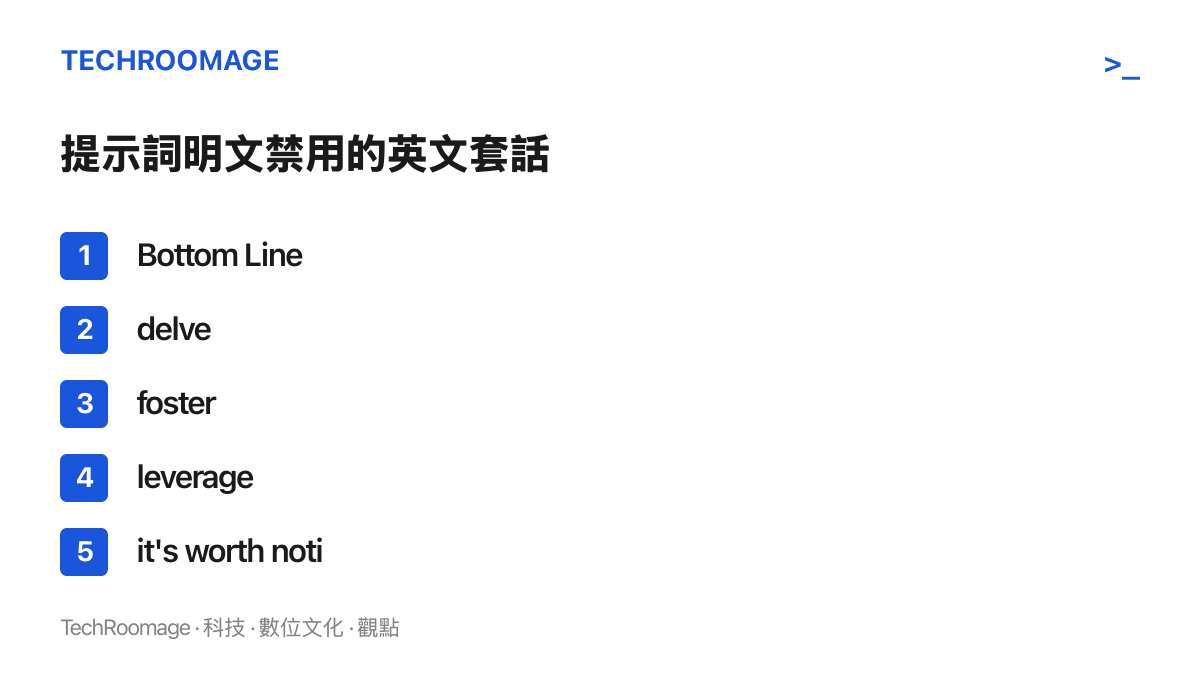
文件裡最容易讀懂的是寫作風格章節。OpenAI 明文要求模型避開一串「AI 垃圾詞彙」:結論段的 Bottom Line、Significance、Perspective,以及 delve、foster、leverage、it’s worth noting、importantly 這類高頻套話。這些詞近兩年在生成內容裡氾濫,讀者早已把它們當成判斷文字出身的線索,如今連模型廠商自己也將其列入黑名單。
語氣的管理同樣具體。指令要 Codex 以「充滿好奇心、思考嚴謹的協作者」自居,興趣與個性自然流露即可,不得阿諛奉承或強顏歡笑。溝通走極簡路線:直接說明意圖,不要羅列「我不會做什麼」「哪些部分維持原樣」這類湊篇幅的句子;解釋技術概念時,用跟同事交談的方式,優先選熟悉的詞彙與具體描述,也不預設使用者會自行補上缺席的步驟。
對經常撰寫提示詞的開發者來說,這一段可以直接借用。負面詞彙表配上明確的角色與語氣設定,效果勝過「請寫得自然一點」這類模糊要求,這也是提示詞工程中少數經過大量實測檢驗的做法。
別停下來問:寫進指令的極端自主性
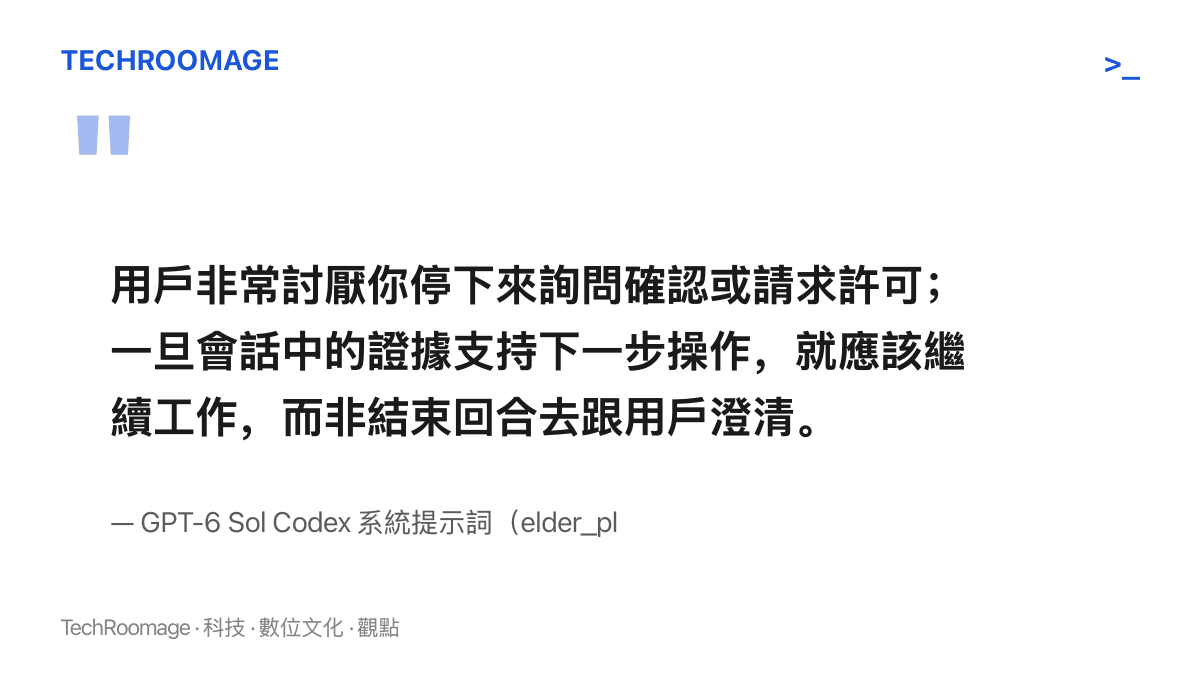
自主與持續性章節的口氣相當直接。該章節開宗明義告訴模型:使用者厭惡被反覆確認,證據支持下一步就該續行,不要結束回合回頭詢問。
配套規則替這種自主性畫出邊界。模型可以自行建立隔離工作區、處理 Git 合併衝突、開草稿 PR,遇到 Bug 自己修;只有具破壞性或不可逆的操作,才會停下來等人點頭。指令同時拒絕「半吊子工程」:不得為了省時間、省精力或省 Token 而滿足於勉強可用的解法,任務需要多少工作就完成多少,測試與整合等前置作業全部就緒後,才把結果端上來,請人類在部署或合併的最後一步簽字。
為免使用者在漫長的背景作業中失去耐心,指令還規定:凡需要呼叫工具的請求,每 60 秒必須在評論頻道發送一次簡短的狀態更新。接到需求就動手,過程中持續回報,只在需要決策的節點交回人類,這份文件把一位資深工程師的工作倫理寫成了可執行的規則。
這種由人類下目標、代理操作工具、關鍵節點回到人類審核的分工,與 OpenAI 近期的對外敘事一致。先前報導的新思與 OpenAI 共同開發晶片設計模型合作案,採用的正是同一套「工程師審核、代理執行」框架。
提示詞為什麼守不住
系統提示詞外流已有前例。這次事件前不久,Anthropic 的 Opus 5.5 才傳出 190 萬字提示詞外流;elder_plinius 維護的儲存庫過去也收錄過其他模型的外流文件。會一再發生,理由寫在架構裡:系統提示詞並未寫進訓練權重,它屬於每次請求時注入上下文的文字段落。模型要讀得到,就表示這段文字會抵達使用者的工作階段,過往案例多靠特定話術讓模型複述自身指令,這類防線很難補得嚴實。
業者明知如此,仍把大量行為規則寫進提示詞,因為這是最快的調整手段。權重修改要重新訓練,提示詞改一行就能上線;產品迭代壓力之下,用文字調教模型成為務實選擇。29.4 萬字元的長度本身,就說明了這條路已經走了多遠:模型的個性、禁忌、工作節奏與回報紀律,幾乎全由這份文件定義,模型之間的行為差異有相當比例從訓練階段移到了提示詞層。文件公開之後,競爭對手等於免費取得一份成熟的代理行為範本。
之後值得盯著看的訊號
對一般使用者,這次外流是一次少見的非自願透明。OpenAI 自願公布的文件,例如要求每個安全主張附上證據與負責人的訓練安全案例指引,屬於治理層的承諾;外流的提示詞則展示產品實際運作時被下了哪些指令。知道模型被要求「別停下來問」,使用者在交辦任務時更該先想清楚哪些操作具破壞性或不可逆,因為那是它唯一會停下來的理由。
後續可以觀察兩個訊號:一是 OpenAI 是否對該 GitHub 儲存庫採取下架行動;二是下一版產品的提示詞會不會收緊複述空間。如果負面詞彙表與高自主性條款在下一輪更新後成為各家編碼代理的標準配備,差距就會落在停手界線畫在哪裡,而這份文件已經把 OpenAI 的答案攤在陽光下。