 Techroomage
同一句話換個位置就讀不到:40 個百分點的相位落差,先考倒評測方法
以字節 Seed 團隊九月底提交的 arXiv 論文為起點,檢視單一平均分數在週期性失效面前的量測極限,檢查換模型與等升級兩種直覺回應的漏洞,並整理讀者可自行執行的相位驗證步驟。
當模型的弱點隨位置週期出現,任何單一平均分都摘要不了它;字節 Seed 團隊量出的相位敏感性,第一個暴露的對象是評測慣例。
字節 Seed 團隊九月底放上 arXiv 的那篇論文,最值得留下的部分,恐怕沒有停留在替 DeepSeek 的「抽風」找到一個技術名稱。它順手示範了一件更麻煩的事:通行的模型評測方法,遇到隨位置週期出現的弱點,從設計上就漏接。論文量出的 40 個百分點相位落差,先考倒的是評測,其次才是模型。
先把時間點說清楚。這份論文(arXiv 編號 2609.36322)提交於九月底,評測對象是 DeepSeek-V4-Flash 與 DeepSeek-V4-Pro 的基礎版和後訓練版,再加上後訓練的 DeepSeek-V4.1-Flash;十月九日 IT之家報導後,這份九月底就掛在預印本平臺上的論文又被翻了出來。研究結論可以壓成一句話:這些模型以分塊 KV 快取壓縮節省長上下文推理的記憶體與注意力成本,壓縮替每個 token 多訂了一個座標,也就是相對於壓縮窗口邊界的位置,論文稱之為相位;同一份資訊的檢索難度隨相位起伏,採用這類壓縮的大型開放權重模型,長上下文檢索準確度在各相位之間最大相差 40 個百分點。
記憶體省下來,token 多了一個座標
長對話的推理成本,有一大塊花在 KV 快取。快取存放每個 token 的鍵值,對話越長,記憶體與注意力計算量越大,動輒數萬 token 的文件問答或連續多輪的代理任務,成本很快壓垮推理服務。分塊壓縮的解法是以固定步幅,把連續 token 的窗口合併成更少的快取條目,記憶體省下來,超長上下文才有辦法商用。
省下來的同時,每個 token 多了一個身分:它落在壓縮窗口的哪個位置。窗口內不同位置的資訊被模型穩定地差別對待,檢索表現隨位置呈週期起伏,論文稱之為相位敏感性。這套機制的來龍去脈與使用者端的症狀,先前已在DeepSeek 的「抽風」出在壓縮記憶體那一步一文裡詳細說過,這裡要追的問題換了一個:這麼大的落差,為什麼拖到現在才被指認。
平均的盲點,是題庫設計出來的
評測長上下文能力的通行做法,是一套題庫跑一遍,回報一個平均準確率。對隨機分布的錯誤,這樣摘要是合理的,樣本夠多,平均就貼近典型體驗。相位敏感性製造的錯誤卻帶著位置週期。題目裡的關鍵資訊落在哪些相位,出題的人通常沒想過,只要抽樣沒有刻意鋪滿整個週期,壞相位的失分就會被好相位攤平。論文也點出,平均基準分數可能掩蓋這種週期性弱點。
40 個百分點是什麼量級?打個比方,同一個模型在好相位答對九成,換到壞相位可能只剩五成。對逐份處理文件、跑完就下班的自動化流程來說,五成命中率代表一半產出要人工重看,在採購評估裡已經屬於另一個等級的產品。而這種等級的差距,平均分數完全可以無感。
使用者那一側的代價更具體。「同一個問題昨天答對、今天答錯」這類回報,第一嫌疑向來是抽樣溫度、伺服器負載或提示詞寫法,很少人會懷疑答案在文件裡的位置。開發長文件問答或代理流程的團隊遇到檢索失敗,先調的是檢索切塊、嵌入模型、工具定義,繞一圈之後才輪到檢查模型本身。錯誤有週期,除錯的直覺沒有,40 個百分點的落差於是有空間安穩存在,直到有人專門去量它。
換模型與等升級,兩個直覺都太便宜
第一個直覺:這是 DeepSeek 的問題,換一家就好。論文量測的確實是 DeepSeek 的三個版本,但機制出在分塊 KV 快取壓縮這條路線本身,論文明寫採用此類壓縮的大型開放權重模型普遍存在這種現象。換模型等於把同類風險一起換進來,而閉源權重模型連被第三方這樣驗證的機會都沒有。這次能被找出來,恰好在於權重開放,研究團隊才有辦法控制變因直接量測。可檢驗性是開放權重最實際的賣點,這件事又添了一個例子。
第二個直覺:等下一版修掉就好。修正之前得先能驗證。下一版若仍只公布平均分,使用者無從判斷相位落差收斂了、變大了,還是換了一組週期繼續存在。升級與驗證是兩件事,中間隔著評測方法有沒有跟上。這份論文對使用者、開發者與模型廠各自的意義,我們先前在Seed 論文點出 DeepSeek 的性能漂移裡整理過,此處要補的是:廠商有沒有修、修了多少,在分相位報告出現之前,外界其實無從對帳。
值得盯的訊號,與一套自己能跑的測法
接下來可以按順序觀察。DeepSeek 官方如何回應是第一順位,路線有兩條,訓練端讓模型對相位不再敏感,或推理端調整壓縮步幅與排法,兩者的成本與效果不同。第二是長上下文相關榜單與評測機構,是否開始加報最差相位分數或相位間變異,這會直接決定這個發現沉澱為標準,還是熱兩週就散。第三是其他開放權重模型是否被第三方用同一套方法檢驗,這是判斷各方重視程度的試紙。
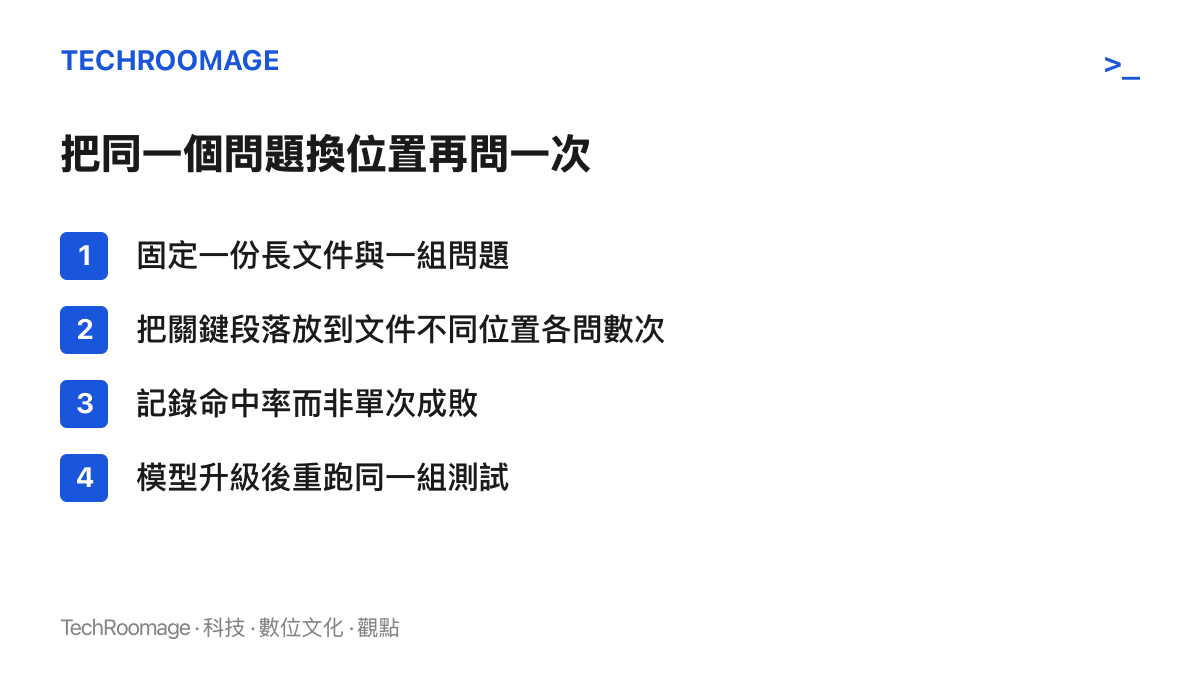
等不到榜單更新的讀者,可以先做一件小事。挑一份夠長的文件和一組固定問題,把關鍵段落挪到文件的不同位置,每個位置各問幾次,記命中率而非單次成敗;模型升級之後重跑同一組測試。這個土法量不出相位座標,但足以回答最實際的問題:這個模型在這類任務上,最差可以差到哪裡。
把驗收標準往前推一格
對看分數選模型的人,判斷標準可以往前推一格:長上下文分數旁邊若只站著一個平均數,就先當作它沒有交代最差狀態來用。Seed 團隊這篇論文的價值,除了指出壞相位在哪裡,也在於提醒所有人,模型能力被壓縮成一個數字的那條生產線,本來就會丟掉一部分真相。榜單不問的問題,使用者只能自己問:同一句話,換個位置還讀得到嗎。
文/沈安